HOPD: Historical On-Policy Distillation for SAR MLLM Continual Learning
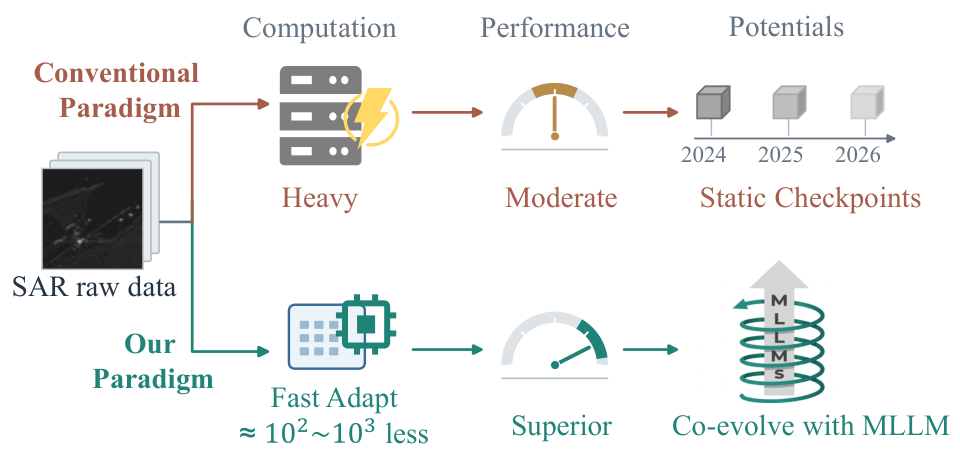
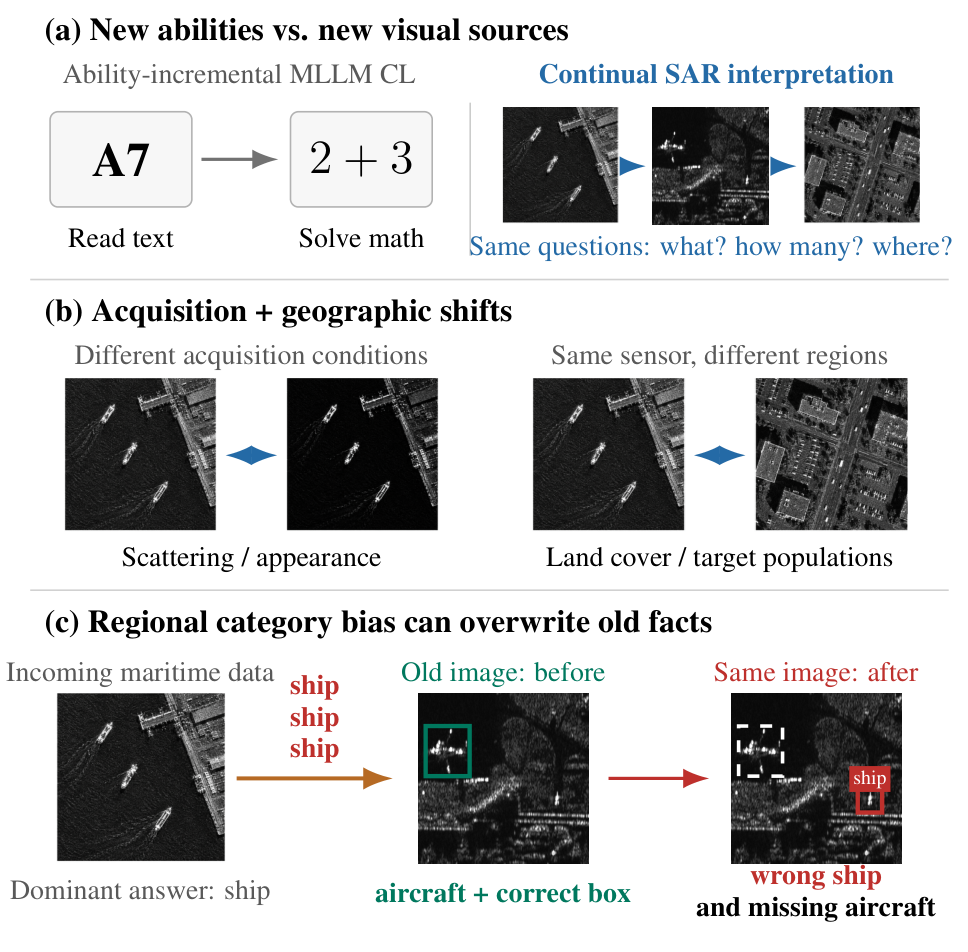
Historical on-policy distillation for continual SAR visual question answering, using source-acquisition LoRA states as persistent teachers to adapt MLLMs across evolving sensors and regions while mitigating catastrophic forgetting.